没有什么比年轻时代更感寂寞的了。——《こころ》

# 概率论

# 随机事件及其概率

# 随机事件及其运算

随机试验:

  • 试验可在相同条件下重复进行。
  • 试验的结果不止一个,且都明确可知。
  • 每次试验之前,不知道哪个结果将会出现。
  • 试验EE 中的每一个可能结果称为基本事件,或称为样本点,所有基本事件组成的集合称为试验EE 的样本空间,记为Ω\Omega。
  • 具有某种性质的样本点构成的集合称为试验EE 的随机事件,简称为事件。用大写字母表示。事件是样本空间的子集。
  • 在随机试验中,事件 A 发生当且仅当 A 包含的某一样本点出现。
  • 又样本空间中所有的样本点组成的事件称为必然事件,就用Ω\Omega 表示,而空集则为不可能事件。

事件的关系:包含、并、交、差、互不相容事件、对立事件都可以对应集合关系。

# 古典概型与几何概型

定义:设在相同的条件下,进行了 n 次试验,在这 n 次试验中事件 A 出现了 m 次,则称:

fn(A)=mnf_n(A)=\frac{m}{n}

为随机事件 A 在 n 次试验中出现的频率,m 称为频数。

  • 经验表明,当试验次数相当大时,频率总是稳定于某一常数附近,以某一常数为中心作微小的摆动,这称为频率的稳定性。

定义:在大量重复试验中,若事件 A 发生的频率稳定在某一常数 p 附近摆动,则称改常数 p 为事件 A 发生的概率,记为P(A)=pP(A)=p。

  • 注意 n 足够大,有fn(A)≈P(A)f_n(A)\approx P(A)。

古典概型定义:设试验结果共有 n 个基本事件ω1,...,ωn\omega_1,...,\omega_n,而且这些事件发生的可能性相等。事件 A 由其中的 m 个基本事件组成,则事件 A 的概率为:

P(A)=mnP(A)=\frac{m}{n}

  • 注意古典概型要求了:
    • 基本事件是有限可数的。
    • 每次试验中,每个基本事件发生是等可能的。

几何概型定义:如果试验EE 的可能结果可以几何地表示为某区域Ω\Omega 中的一个点,并且点落在Ω\Omega 中某区域 A 的概率与 A 的测度成正比,而与 A 的形状无关。则随机点落在区域 A 的概率为:

P(A)=mAmΩP(A)=\frac{mA}{m\Omega}

其中mAmA 表示 A 的测度。

# 概率的公理化定理及其性质

  • 几何概型中,由于计算事件的概率需要几何图形的测度,因此不能把不可测集当作事件。于是我们可以递归定义事件集合。(即产生了全部的合法事件)
  • $\Omega \in \mathscr{F} $
  • 若A∈FA\in\mathscr{F},则\bar{A} \in \mathscr
  • 若An∈F,n=1,2,3,...A_n\in\mathscr{F},n=1,2,3,...,则⋃n=1∞An∈F\bigcup_{n=1}^{\infin}A_n\in\mathscr{F}(其实这个要求结合上前两个也就可以证明集合对交封闭)
  • 满足上述三个规定的子集称为σ\sigma 域,或称σ\sigma 代数,在概率论中我们称为事件域。

    • 例:一维博雷尔域:一切形如[a,b)[a,b) 的有界左闭右开的开区间构成的集类产生的σ\sigma 域。(注意并不是说博雷尔σ\sigma 域中所有元素都是形如[a,b)[a,b) 的,而是说元素都是由{[a,b)∣a,b∈R}\{[a,b)|a,b\in R\} 和上面三条规则生成的)对博雷尔域,有:

      • {x}=⋂n=1∞[x,x+1n)\{x\}=\bigcap_{n=1}^\infin[x,x+\frac{1}{n})
      • (x,y)=[x,y)- \
      • [x,y]=[x,y)+ \
      • (x,y]=[x,y)+ \{ y \}- \

      因此,任何一维实数区间都是博雷尔域中的元素。

概率的公理化:对于样本空间的一个事件域,若对于事件域中的任何一个事件 A,都有一个实数P(A)P(A) 与之对应,并且满足:

  • 非负性:P(A)≥0P(A)\geq 0

  • 规范性:P(Ω)≥0P(\Omega)\geq 0

  • 可列可加性:对于两两互不相容的可列个事件A1,...,An,...A_1,...,A_n,...,有

P(∑i=1∞Ai)=∑i=1∞P(Ai) P(\sum_{i=1}^\infin A_i)=\sum_{i=1}^\infin P(A_i)

则称P(A)P(A) 为事件 A 的概率。

显然概率有可列可加,可减,单调性等等。

  • 上下连续性:若有A1⊂A2⊂...⊂An⊂...A_1\subset A_2\subset ...\subset A_n\subset...,则:

    P(⋃i=1∞Ai)=lim⁡n→∞P(An)P(\bigcup_{i=1}^\infin A_i)=\lim_{n\rightarrow\infin}P(A_n)\\

    若有A1⊃A2⊃...⊂An⊃...A_1\supset A_2\supset...\subset A_n\supset...,则:

    P(⋂i=1∞Ai)=lim⁡n→∞P(An)P(\bigcap_{i=1}^\infin A_i)=\lim_{n\rightarrow\infin}P(A_n)

概率空间:三元组(Ω,F,P)(\Omega,\mathscr{F},P)。

# 条件概率与事件独立性

  • 事件 A 发生的前提下,事件 B 发生的概率称为条件概率,记为:P(B∣A)P(B|A)。

设(Ω,F,P)(\Omega,\mathscr{F},P) 是一个概率空间,A∈FA\in\mathscr{F},P(A)>0P(A)>0。则对任意B∈FB\in\mathscr{F},记:

P(B∣A)=P(AB)P(A)P(B|A)=\frac{P(AB)}{P(A)}

  • 条件概率也满足:

    • 非负性:∀B,P(B∣A)≥0\forall B,P(B|A)\geq 0
    • 规范性:P(Ω∣A)=1P(\Omega|A)=1
    • 可列可加性:P(∑i=1∞Ai∣B)=∑i=1∞P(Ai∣B)P(\sum_{i=1}^\infin A_i|B)=\sum_{i=1}^\infin P(A_i|B)
  • 条件概率的乘法公式:

    P(A1A2...An)=P(A1)P(A2∣A1)P(A3∣A1A2)...P(An∣A1A2...An−1)P(A1A2...An−1)>0P(A_1A_2...A_n)=P(A_1)P(A_2|A_1)P(A_3|A_1A_2)...P(A_n|A_1A_2...A_{n-1})\\ P(A_1A_2...A_{n-1})>0

若对概率空间中的两个事件 A,B,有:

P(AB)=P(A)P(B)P(AB)=P(A)P(B)

则称事件 A 与事件 B 是相互独立。否则称他们不相互独立,或相依的。

  • 定理:若事件 A 与 B 相互独立,则事件Aˉ\bar{A} 和BB 也是相互独立的。

对于三个事件A,B,CA,B,C,若有:

{P(AB)=P(A)P(B)P(AC)=P(A)P(C)P(BC)=P(B)P(C)\begin{cases}P(AB)=P(A)P(B)\\P(AC)=P(A)P(C)\\P(BC)=P(B)P(C)\end{cases}

则称它们两两独立。若有:

{P(AB)=P(A)P(B)P(AC)=P(A)P(C)P(BC)=P(B)P(C)P(ABC)=P(A)P(B)P(C)\begin{cases}P(AB)=P(A)P(B)\\P(AC)=P(A)P(C)\\P(BC)=P(B)P(C)\\P(ABC)=P(A)P(B)P(C)\end{cases}

则称 A, B, C 相互独立。

  • 相互独立可以推出两两独立,但两两独立无法推出相互独立。一般地,对于一个事件序列A1,...,An,...A_1,...,A_n,...,若其中任意有限个事件都相互独立,则称A1,...,An,...A_1,...,A_n,... 是独立事件序列。

# 全概率公式与贝叶斯公式

定义:设A1,...,AnA_1,...,A_n 是一组事件,若它们两两互不相容,而且:

∑i=1nAi=Ω\sum_{i=1}^n A_i=\Omega

则称它们是样本空间的一个分割,亦称完备事件组。

全概率公式:对于Ω\Omega 的一个分割A1,...,An,P(Ai)>0A_1,...,A_n,P(A_i)>0, 有:

∀B∈F,P(B)=∑i=1nP(B∣Ai)\forall B\in\mathscr{F},P(B)=\sum_{i=1}^nP(B|A_i)

  • 我愿称之为形式化的分类讨论。

贝叶斯公式:对于概率空间(Ω,F,P)(\Omega,\mathscr{F},P),A1,A2,...,AnA_1,A_2,...,A_n 是样本空间的一个分割,则对任意B∈FB\in\mathscr{F},P(B)>0P(B)>0,有:

P(Ak∣B)=P(Ak)P(B∣Ak)∑j=1nP(Aj)P(B∣Aj),k=1,2,...,nP(A_k|B)=\frac{P(A_k)P(B|A_k)}{\sum_{j=1}^n P(A_j)P(B|A_j)},k=1,2,...,n

  • 我愿称之为展开的概率反演。P(A∣B)=P(AB)/P(B)=P(AB)/P(A)∗P(A)/P(B)=P(B∣A)∗P(A)/P(B)P(A|B)=P(AB)/P(B)=P(AB)/P(A)*P(A)/P(B)=P(B|A)*P(A)/P(B)。

# 伯努利概型

若试验E1E_1 的任一结果(事件)都与试验E2E_2 的任一结果(事件)相互独立,则称这两个试验相互独立。若试验E1,...,EnE_1,...,E_n 相互独立,则称其为 n 重重复试验。

若试验E1E_1 的可能结果只有AA 和Aˉ\bar{A},则称其为伯努利试验。若将E1E_1 重复进行 n 次,且 n 次试验都相互独立,则称为 n 重伯努利试验。

  • n 重伯努利试验中,事件 A 发生 k 次的概率:

    Pn(k)=Cnkpk(1−p)n−k,P(A)=pP_n(k)=C_n^kp^k(1-p)^{n-k},P(A)=p

# 随机变量及其分布

# 随机变量与分布函数

定义:设X(ω)X(\omega) 是定义在概率空间(Ω,F,P)(\Omega,\mathscr{F},P) 上的单值实函数,即对每个ω∈Ω\omega\in\Omega,都有X(ω)∈RX(\omega)\in R,并且对任意x∈Rx\in R,{ω∣X(ω)≤x}\{\omega|X(\omega)\leq x\} 都是随机事件(即其∈F\in\mathscr{F})则称X(ω)X(\omega) 是概率空间上的随机变量。通常简记为 X。

  • 分布函数:X∼F(x)=P(X≤x)X\sim F(x)=P(X\leq x)。定理:
    • 单调不减:a<b⇒F(a)≤F(b)a<b\Rightarrow F(a)\leq F(b)。
    • 0≤F(x)≤1,lim⁡n→+∞F(x)=1,lim⁡n→−∞F(x)=−10\leq F(x)\leq 1,\lim_{n\rightarrow +\infin}F(x)=1,\lim_{n\rightarrow-\infin}F(x)=-1。
    • 右连续性:F(x)F(x) 在任何点 x 处右连续。
      • 用⋂{X≤x+1n}={X≤x}\bigcap\{X\leq x+\frac{1}{n}\}=\{X\leq x\} 和右极限=lim⁡n→∞F(x+1n)=\lim_{n\rightarrow\infin}F(x+\frac{1}{n}) 来证明。
  • 随机变量有离散型,非离散型(连续型,奇异型)等等分类。

# 离散型随机变量及其分布

设离散型随机变量 X 的所有可能取得值为x1,...,xnx_1,...,x_n,而 X 取xkx_k 的概率为pkp_k,即P(X=xk)=pk(k=1,...,n)P(X=x_k)=p_k(k=1,...,n)。

称上式为随机变量 X 的概率分布律。

  • 常见分布:

    • 退化分布:P(X=C)=1P(X=C)=1

    • 两点分布:P(X=0)=p,P(X=1)=1−pP(X=0)=p,P(X=1)=1-p

    • 二项分布:P(X=k)=C_n^kp^k(1-p)^

      • 当(n+1)p(n+1)p 为整数时,在k=(n+1)p,(n+1)p−1k=(n+1)p,(n+1)p-1 处概率取得最大值。若不为整数,则在[(n+1)p][(n+1)p] 取得最大值。于是[(n+1)p][(n+1)p] 称为二项分布B(n,p)B(n,p) 的最可能出现次数,或称最可能值。
      • E[X]=np,D(X)=np(1−p)E[X]=np,D(X)=np(1-p)
    • 几何分布:P(X=k)=(1−p)k−1pP(X=k)=(1-p)^{k-1}p,记为X∼G(p)X\sim G(p)。有∑i=1∞P(X=k)=1\sum_{i=1}^\infin P(X=k)=1。

    • 超几何分布:N 件产品中有 M 件次品,现抽 n 件出来,其中的次品数服从超几何分布:

      P(X=k)=CMkCN−Mn−kCNn,k=1,..,min(n,M)P(X=k)=\frac{C_M^kC_{N-M}^{n-k}}{C_N^n},k=1,..,min(n,M)

泊松定理:设随机变量Xn∼B(n,pn),(n=1,2,...)X_n\sim B(n,p_n),(n=1,2,...)。若有lim⁡n→∞npn=λ\lim_{n\rightarrow\infin}np_n=\lambda,则有:

lim⁡n→∞P(Xn=k)=λkk!e−λ\lim_{n\rightarrow\infin}P(X_n=k)=\frac{\lambda^k}{k!}e^{-\lambda}

  • 泊松分布:X∼P(λ)X\sim P(\lambda):

    P(X=k)=λkk!e−λ,k=0,1,2,...P(X=k)=\frac{\lambda^k}{k!}e^{-\lambda},k=0,1,2,...

    自然界很多稀疏现象都服从泊松分布,故其又称为稀疏现象律。泊松分布最可能值为λ,λ−1\lambda,\lambda -1 或[λ][\lambda]。

    • E[X]=λ,D(X)=λE[X]=\lambda,D(X)=\lambda

# 连续型随机变量及其分布

定义:设随机变量 X 的概率分布函数为F(x)F(x),如果存在一个函数f(x)f(x),对于任意实数 x,都有:

F(x)=∫−∞xf(t)dt,x∈RF(x)=\int_{-\infin}^xf(t)dt,x\in R

则称 X 为连续性随机变量,f(x)f(x) 为 X 的概率密度函数。

  • 连续型随机变量有:P(X=a)=0,P(a≤X≤b)=P(a<X≤b)=P(a≤X<b)=P(a<X<b)P(X=a)=0,P(a\leq X\leq b)=P(a<X\leq b)=P(a\leq X<b)=P(a<X<b)。

  • 一个事件概率为零,他并不一定是不可能事件(空集)。同样,概率为 1 的也不一定是必然事件。

  • 常见分布:

    • 均匀分布:X∼U[a,b]X\sim U[a,b]:

      f(x)={1b−aa≤x≤b0elsef(x)=\begin{cases}\frac{1}{b-a}&a\leq x\leq b\\0&else\end{cases}

    • 指数分布:X∼E(λ)X\sim E(\lambda):

      f(x)={λe−λxx>00x≤0f(x)=\begin{cases}\lambda e^{-\lambda x}&x>0\\0&x\leq 0\end{cases}

      • 指数分布具有无记忆性:P(X>s+t∣X>s)=P(X>t)P(X>s+t|X>s)=P(X>t)。
  • E[X]=\frac{1}{\lambda},D(X)=\frac{1}

    • 正态分布:X∼N(μ,σ2)X\sim N(\mu,\sigma^2):

      f(x)=12πσe−(x−μ)22σ2,x∈Rf(x)=\frac{1}{\sqrt{2\pi}\sigma}e^{-\frac{(x-\mu)^2}{2\sigma^2}},x\in R

      • 标准正态分布的概率函数和分布函数记为φ(x),Φ(x)\varphi(x),\Phi(x)。有Φ(−x)=1−Φ(x)\Phi(-x)=1-\Phi(x)(关于 y 轴对称)。
      • 3σ\sigma 原则:正态分布几何全部的取值都落在[μ−3σ,μ+3σ][\mu-3\sigma,\mu+3\sigma] 内。

# 随机变量函数的分布

  • 定理:设连续型随机变量XX 具有概率密度函数fX(x)f_X(x),其可能的取值范围为(a,b)(a,b)(可以到无穷)。则:

    • 若函数y=g(x)y=g(x) 在区间(a,b)(a,b) 上严格单调,其反函数x=g−1(y)x=g^{-1}(y) 有连续的导函数,则Y=g(X)Y=g(X) 也是连续型随机变量,其概率密度函数为:

      fY(y)={fX(g−1(y))∣(g−1)′(y)∣min(g(a),g(b))<y<max(g(a),b(b))0elsef_Y(y)=\begin{cases}f_X(g^{-1}(y))|(g^{-1})'(y)|& min(g(a),g(b))<y<max(g(a),b(b))\\0&else\end{cases}

    • 若函数y=g(x)y=g(x) 在区间(a,b)(a,b) 中不重叠的区间I1,...,InI_1,...,I_n 上逐段严格单调,其反函数h1(y),...,hn(y)h_1(y),...,h_n(y) 在段内均有连续导函数,则 Y 也是连续型随机变量:

      fY(y)=∑i=1nfX(hi(y))∣hi′(y)∣f_Y(y)=\sum_{i=1}^nf_X(h_i(y))|h_i'(y)|

# 多维随机变量及其分布

# 二维随机变量及其分布

定义:设(X,Y)(X,Y) 是二位随机变量,对任意实数x,yx,y,二元函数 $ F (x,y)=P (X\leq x,Y\leq y)称为随机变量称为随机变量 (X,Y)$ 的联合分布函数。

  • 特别地,如果二阶偏导数f(x,y)f(x,y) 连续(即与求偏导顺序无关),则定义f(x,y)=∂2F(x,y)∂x∂yf(x,y)=\frac{\partial^2F(x,y)}{\partial x\partial y} 为联合密度函数。
    • 二维正态分布
    • 二维均匀分布

# 边缘分布

记二维随机变量的分布函数F(x,y)F(x,y) 关于XX 和YY 的边缘分布函数为FX(x)=F(x,+∞),FY(y)=F(+∞,y)F_X(x)=F(x,+\infin),F_Y(y)=F(+\infin,y)。同样也有边缘概率密度函数:fX(x)=∫−∞+∞f(x,y)dyf_X(x)=\int_{-\infin}^{+\infin}f(x,y)dy。

  • 二维正态分布的边缘分布仍为正态分布。
  • 边缘分布的理解就是不论 y 取什么,只考虑 x 的取值情况。就像对多量子比特系统中,对单一比特进行测量之后引起的系统的坍塌。

# 条件分布

条件概率分布函数的定义为:FY∣X(y∣x)=F(x,y)fX(x)=∫−∞yf(x,v)dvfX(x)F_{Y|X}(y|x)=\frac{F(x,y)}{f_X(x)}=\int_{-\infin}^y\frac{f(x,v)dv}{f_X(x)},条件概率密度函数为f_{Y|X}(y|x)=\frac{f(x,y)}

# 随机变量的独立性

若对二维随机变量(X,Y)(X,Y),有∀x,y.F(x,y)=FX(x)FY(y)\forall x,y.F(x,y)=F_X(x)F_Y(y) 或f(x,y)=fX(x)fY(y)f(x,y)=f_X(x)f_Y(y)(两式等价),则称 X 与 Y 相互独立。

# 二维随机变量函数的分布

令Z=g(X,Y)Z=g(X,Y),一般会先求ZZ 的分布函数FZ(z)=∬g(x,y)≤zf(x,y)dxdyF_Z(z)=\iint_{g(x,y)\leq z}f(x,y)dxdy,然后再求导得到fZ(z)f_Z(z)。

  • 若Z=X+YZ=X+Y,有fZ(z)=∫−∞+∞f(x,z−x)dx=∫−∞+∞f(z−y,y)dyf_Z(z)=\int_{-\infin}^{+\infin}f(x,z-x)dx=\int_{-\infin}^{+\infin}f(z-y,y)dy。(令u=x+yu=x+y)概率密度函数卷积公式
  • 若Z=XYZ=\frac{X}{Y},有fZ(z)=∫−∞+∞f(yz,y)∣y∣dyf_Z(z)=\int_{-\infin}^{+\infin}f(yz,y)|y|dy。
  • 若Z=max(X,Y)Z=max(X,Y),有FZ(z)=FX(z)FY(z)F_Z(z)=F_X(z)F_Y(z)。(若 X,Y 相互独立)
  • 若Z=min(X,Y)Z=min(X,Y),有FZ(z)=1−[1−FX(z)][1−FY(z)]F_Z(z)=1-[1-F_X(z)][1-F_Y(z)]。

# 随机变量的数字特征与极限定理

# 数学期望

设连续型随机变量XX 的概率密度函数为f(x)f(x),若积分∫−∞+∞xf(x)dx\int_{-\infin}^{+\infin}xf(x)dx 绝对收敛,则称该积分值为 X 的数学期望。

  • 若积分∫−∞+∞g(x)f(x)dx\int_{-\infin}^{+\infin}g(x)f(x)dx 绝对收敛,则有:

    E[g(X)]=∫−∞+∞g(x)f(x)dxE[g(X)]=\int_{-\infin}^{+\infin}g(x)f(x)dx

  • 对任意随机变量 X,Y 都有E[X+Y]=E[X]+E[Y]E[X+Y]=E[X]+E[Y],但只有当它们独立时,才有E[XY]=E[X]E[Y]E[XY]=E[X]E[Y]。

  • 柯西 - 施瓦泽不等式:(E[XY])2≤E[X2]E[Y2](E[XY])^2\leq E[X^2]E[Y^2]。

# 方差

设 X 是随机变量,如果E[(X−E(X))2]E[(X-E(X))^2] 存在,则称之为 X 的方差,记为D(X)D(X)。

  • D(X)=E[(X−E[X])2]=E[X2]−2E[X]E[X]+E[X]2=E[X2]−E[X]2D(X)=E[(X-E[X])^2]=E[X^2]-2E[X]E[X]+E[X]^2=E[X^2]-E[X]^2。

# 协方差与相关系数

定义Cov(X,Y)=E[(X−E[X])(Y−E[Y])]Cov(X,Y)=E[(X-E[X])(Y-E[Y])] 称为随机变量XX 和YY 的协方差,ρXY=Cov(X,Y)D(X)D(Y)\rho_{XY}=\frac{Cov(X,Y)}{\sqrt{D(X)}\sqrt{D(Y)}} 称为随机变量 X 和 Y 的相关系数。

  • 常用计算协方差方法:Cov(X,Y)=E[XY]−E[X][Y]Cov(X,Y)=E[XY]-E[X][Y]。

  • 性质:

    • Cov(X,Y)=Cov(Y,X)Cov(X,Y)=Cov(Y,X)
    • Cov(a1X+b1,a2Y+b2)=a1a2Cov(X,Y)Cov(a_1X+b_1,a_2Y+b_2)=a_1a_2Cov(X,Y)
    • Cov(X1+X2,Y)=Cov(X1,Y)+Cov(X2,y)Cov(X_1+X_2,Y)=Cov(X_1,Y)+Cov(X_2,y)
    • D(X±Y)=D(X)+D(Y)±2Cov(X,Y)D(X\pm Y)=D(X)+D(Y)\pm 2Cov(X,Y)
    • X,YX,Y 独立⇔Cov(X,Y)=0\Leftrightarrow Cov(X,Y)=0
    • ∣ρXY∣≤1|\rho_{XY}|\leq 1,且取等的充要条件是XX 和YY 呈线性关系。
  • 一般来说,∣ρXY∣|\rho_{XY}| 越大,X 和 Y 的 “线性相关” 越强,若ρXY=0\rho_{XY}=0,则它们独立。注意,当且仅当ρXY=0\rho_{XY}=0 时称他们不相关。

  • XX 和YY 独立⇒Cov(X,Y)=0\Rightarrow Cov(X,Y)=0,反之不一定成立。譬如X∼U[−1,1],Y=X2X\sim U[-1,1],Y=X^2。

称E[Xk]E[X^k] 为 X 的 k 阶原点矩。

称E[(X−E[X])2]E[(X-E[X])^2] 为 X 的 k 阶中心矩。

称E[XkYl]E[X^kY^l] 为 X 和 Y 的 k+l 阶混合矩。

称E[(X−E[X])k(Y−E[Y])l]E[(X-E[X])^k(Y-E[Y])^l] 为 X 和 Y 的 k+l 阶中心混合矩。

# 大数定律

切比雪夫不等式:

∀ε>0,P(∣X−E[X]∣≥ε)≤D(X)ε2\forall \varepsilon>0,P(|X-E[X]|\geq\varepsilon)\leq\frac{D(X)}{\varepsilon^2}

  • 切比雪夫大数定律:

    设随机变量X1,...,Xn,...X_1,...,X_n,... 相互独立,且有相同的数学期望和方差,即:E[Xk]≡μ,D(Xk)≡σ2E[X_k]\equiv \mu,D(X_k)\equiv \sigma^2,则有:

    ∀ε>0,lim⁡n→∞P(∣1n∑k=1nXk−μ∣<ε)=1\forall\varepsilon >0,\lim_{n\rightarrow\infin}P(|\frac{1}{n}\sum_{k=1}^nX_k-\mu|<\varepsilon)=1

  • 辛钦大数定律:

    设随机变量X1,...,Xn,...X_1,...,X_n,... 独立同分布,且有相同的数学期望,即E[Xk]≡μE[X_k]\equiv\mu,则:

    ∀ε>0,lim⁡n→∞P(∣1n∑k=1nXk−μ∣<ε)=1\forall\varepsilon>0,\lim_{n\rightarrow\infin}P(|\frac{1}{n}\sum_{k=1}^{n}X_k-\mu|<\varepsilon)=1

    它不要求方差的存在,但要求同分布。

  • 伯努利大数定律:

    在伯努利概型中(n 次独立重复试验,k 为事件 A 发生的次数,每次试验 A 发生的概率为 p),有:

    ∀ε>0,lim⁡n→∞P(∣knn−p∣<ε)=1\forall\varepsilon>0,\lim_{n\rightarrow\infin}P(|\frac{k_n}{n}-p|<\varepsilon)=1

    伯努利大数定律从理论上说明任一随机事件的频率具有稳定性。因此可以在大量试验后,将发生的频率近似作为概率。

# 中心极限定理

很多独立随机变量的极限分布是正态分布。

  • 列维 - 林德伯格中心极限定理:

    设X1,X2,...,Xn,...X_1,X_2,...,X_n,... 是独立同分布的随机变量:E[Xk]≡μ,D(Xk)≡σ2E[X_k]\equiv \mu,D(X_k)\equiv\sigma^2,则有:

    ∀x,lim⁡n→∞P(∑i=1nXk−nμσn≤x)=Φ(x)\forall x,\lim_{n\rightarrow\infin}P(\frac{\sum_{i=1}^nX_k-n\mu}{\sigma\sqrt{n}}\leq x)=\Phi(x)

    即独立同分布的随机变量之和∑i=1nXk\sum_{i=1}^nX_k 近似于正态分布N(nμ,nσ2)N(n\mu,n\sigma^2)。所以Xˉ−μσ/n\frac{\bar{X}-\mu}{\sigma/\sqrt{n}} 近似服从N(0,1)N(0,1)。

  • 蒂莫夫 - 拉普拉斯中心极限定理:

    设YnY_n 服从二项分布B(n,p)B(n,p),则有:

    ∀x,lim⁡n→∞P(Yn−npnp(1−p)≤x)=Φ(x)\forall x,\lim_{n\rightarrow\infin}P(\frac{Y_n-np}{\sqrt{np(1-p)}}\leq x)=\Phi(x)

    即 n 充分大时,二项分布近似于服从N(np,np(1−p))N(np,np(1-p))。

  • 不同分布的中心极限定理:
    设X1,...,Xn,...X_1,...,X_n,... 是独立不同分布的随机变量,D(Xi)=σi2D(X_i)=\sigma_i^2。若:

    {lim⁡n→∞∑i=1nσi2=∞lim⁡n→∞max(σi2)n=0\begin{cases}\lim_{n\rightarrow\infin}\sum_{i=1}^n\sigma_i^2=\infin\\\lim_{n\rightarrow\infin}\frac{max(\sigma_i^2)}{n}=0\end{cases}

    则:

    Y=lim⁡n→∞∑i=1nXinY=\lim_{n\rightarrow\infin}\frac{\sum_{i=1}^nX_i}{n}

    服从正态分布。它表示,由足够多的随机变量,但每个随机变量又不起决定性作用,他们的平均随机变量服从正态分布。

# 数理统计

# 数理统计基本知识

# 总体与样本

  • 从整体中抽取的待测的个体组成的集合称为样本。

简单随机样本需要满足:

  • 独立性:X1,...,XnX_1,...,X_n 是相互独立的随机变量。
  • 代表性:X1,...,XnX_1,...,X_n 要与总体XX 有相同的分布。

设X1,...,XnX_1,...,X_n 为来自总体XX 的简单随机样本,则有:

  • X1,...,XnX_1,...,X_n 的联合分布函数为:FX1,...,Xn(x1,...,xn)=∏i=1nF(xi)F_{X_1,...,X_n}(x_1,...,x_n)=\prod_{i=1}^n F(x_i),其中F(x)F(x) 是总体XX 的分布函数。
  • E[Xi]≡E[X],D(Xi)≡D(X)E[X_i]\equiv E[X],D(X_i)\equiv D(X)。

# 统计量与三大分布

不含任何未知参数,只关于样本的实值函数称为样本的一个统计量。常用统计量:

  • 均值:Xˉ=∑i=1nXi\bar{X}=\sum_{i=1}^nX_i

  • 样本方差:S2=1n−1∑i=1n(Xi−Xˉ)2=1n−1(∑i=1nXi2−nXˉ)S^2=\frac{1}{n-1}\sum_{i=1}^n(X_i-\bar{X})^2=\frac{1}{n-1}(\sum_{i=1}^nX_i^2-n\bar{X}),这里为什么是除以n−1n-1 呢,是因为要保证标准差的无偏性,在后面 “估计量的优劣评价” 中会提到。

  • 样本标准差:S=\sqrt

  • 样本 k 阶原点矩:Ak=1n∑i=1nXikA_k=\frac{1}{n}\sum_{i=1}^nX_i^k

  • 样本 k 阶中心矩:Bk=1n∑i=1n(Xi−Xˉ)2B_k=\frac{1}{n}\sum_{i=1}^n(X_i-\bar{X})^2

  • 顺序统计量:最小、最大统计量max(X1,...,Xn),min(X1,...,Xn)max(X_1,...,X_n),min(X_1,...,X_n)

二维统计量:

  • 协方差:SXY2=1n−1∑i=1n(Xi−Xˉ)(Yi−Yˉ)S_{XY}^2=\frac{1}{n-1}\sum_{i=1}^n(X_i-\bar{X})(Y_i-\bar{Y})
  • 样本相关系数:\rho_{XY} = \frac{S_{XY}^2}

三大分布:

  • χ2\chi^2 分布:

    设随机变量X1,...,XnX_1,...,X_n 独立且都服从标准正态分布,则:

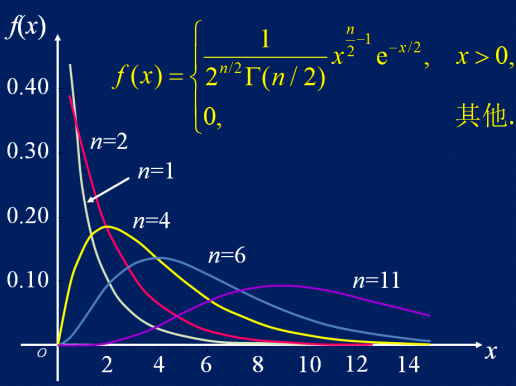
    χ2=X12+...+Xn2fχ2(x)={12n/2Γ(n/2)xn2−1e−x/2x>00x≤0\chi^2=X_1^2+...+X_n^2\\ f_{\chi^2}(x)=\begin{cases}\frac{1}{2^{n/2}\Gamma(n/2)}x^{\frac{n}{2}-1}e^{-x/2}&x>0\\0&x\leq 0\end{cases}

    有E[χ2(n)]=n,D[χn(n)]=2nE[\chi^2(n)]=n,D[\chi^n(n)]=2n。

    χ2(m)+χ2(n)=χ2(m+n)\chi^2(m)+\chi^2(n)=\chi^2(m+n)。图像:

    1

  • t 分布(学生分布):

    设随机变量X,YX,Y 相互独立,且X∼N(0,1),Y∼χ2(n)X\sim N(0,1),Y\sim\chi^2(n),则:

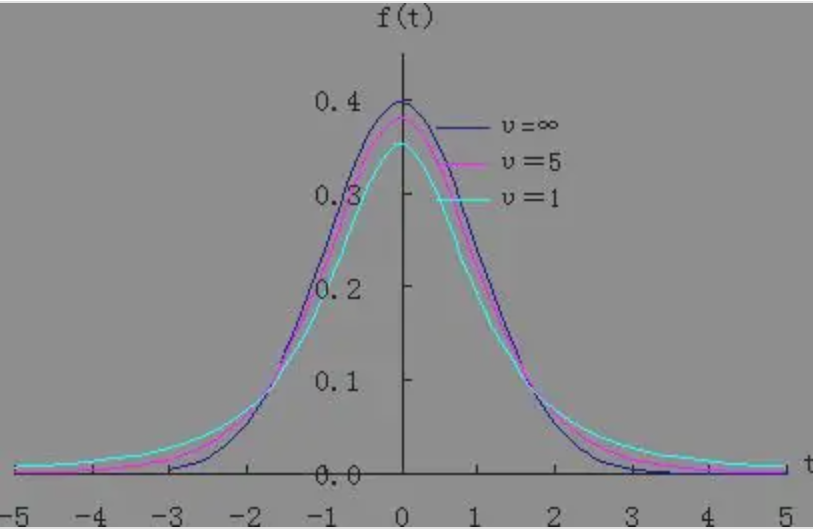
    t=XY/nft(x)=Γ[(n+1)/2]nπΓ(n/2)(1+x2n)−n+12t=\frac{X}{\sqrt{Y/n}}\\ f_t(x)=\frac{\Gamma[(n+1)/2]}{\sqrt{n\pi}\Gamma(n/2)}(1+\frac{x^2}{n})^{-\frac{n+1}{2}}

    有E[t(n)]=0(n>1),D[t(n)]=nn−2(n>2)E[t(n)]=0(n>1),D[t(n)]=\frac{n}{n-2}(n>2)。

    当n≥30n\geq 30 时,已经可以将 t 分布近似看成标准正态分布。图像:

    2

  • F 分布:

    设随机变量XX 和YY 相互独立,且X∼χ2(m),Y∼χ2(n)X\sim\chi^2(m),Y\sim\chi^2(n),则:

    F=X/mY/nF=\frac{X/m}{Y/n}\\

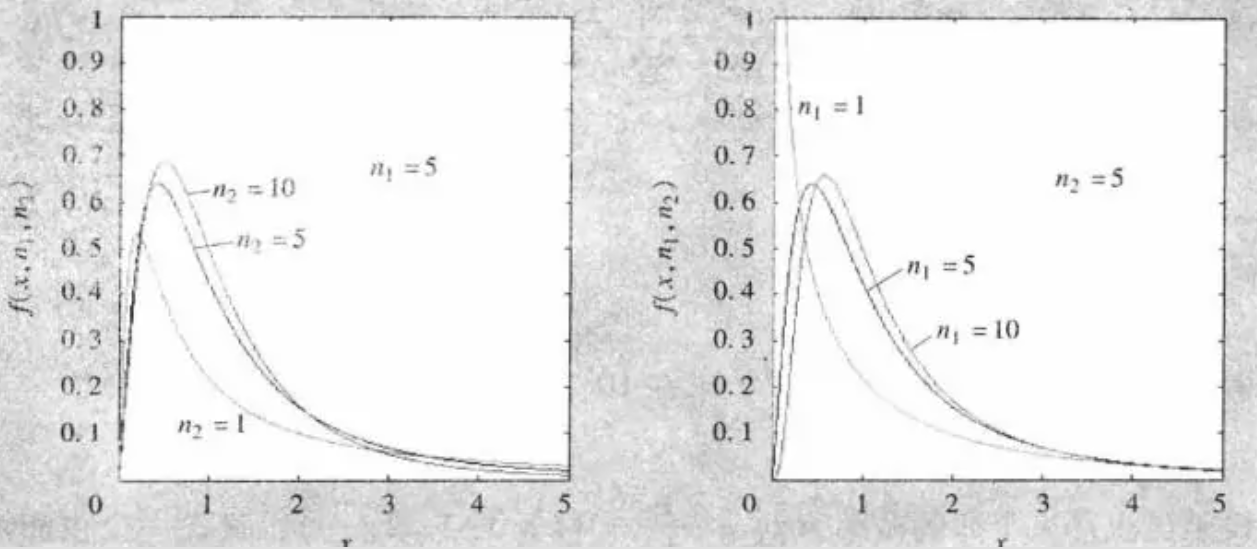
    有E[F(m,n)]=nn−2,D[F(m,n)]=2n2(m+n−2)m(n−2)2(n−4)E[F(m,n)]=\frac{n}{n-2},D[F(m,n)]=\frac{2n^2(m+n-2)}{m(n-2)^2(n-4)},且F∼F(m,n)⇒1F∼F(n,m)F\sim F(m,n)\Rightarrow\frac{1}{F}\sim F(n,m)。图图:

    3

    这些图一个比一个丑


上分位数点:P(X>xα)=1−F(xα)=αP(X>x_\alpha)=1-F(x_\alpha)=\alpha,则xαx_\alpha 称为 X 的上α\alpha 分位点。

  • 正态分布的上分位点记为uαu_\alpha。
  • n≥40n\geq 40 时,χα2(n)≈12(uα+2n−1)2\chi^2_\alpha(n)\approx\frac{1}{2}(u_\alpha+\sqrt{2n-1})^2
  • 由 t 分布的对称性,有t1−α(n)=−tα(n)t_{1-\alpha}(n)=-t_\alpha(n)
  • F_{1-\alpha}(m,n)=\frac{1}

顺序统计量的分布:设总体 X 具有分布函数F(x)F(x),其密度函数为f(x)f(x)。则:

  • X_{(1)}=min(X_1,...,X_n),f_{X_{(1)}}(x) = nf(x) [1-F(x)]^
  • X_{(n)}=max(X_1,...,X_n),f_{X_{(n)}}(x) = nf(x)[F(x)]^
  • fX(1),X(n)(x,y)=n(n−1)f(x)f(y)[F(y)−F(x)]n−2(x≤y)f_{X_{(1)},X_{(n)}}(x,y)=n(n-1)f(x)f(y)[F(y)-F(x)]^{n-2}(x\leq y)。
  • fX(k)(x)=kCnkF(x)k−1[1−F(x)]n−kf(x)f_{X_{(k)}}(x)=kC_n^kF(x)^{k-1}[1-F(x)]^{n-k}f(x)

# ☆正态总体的抽样分布

设X1,...,XnX_1,...,X_n 是来自正态总体X∼N(μ,σ2)X\sim N(\mu,\sigma^2) 的一组样本,则:

  • Xˉ∼N(μ,σ2n)\bar{X}\sim N(\mu,\frac{\sigma^2}{n})
  • (n−1)S2σ2∼χ2(n−1)\frac{(n-1)S^2}{\sigma^2}\sim\chi^2(n-1)
  • Xˉ−μS/n∼t(n−1)\frac{\bar{X}-\mu}{S/\sqrt{n}}\sim t(n-1)
  • Xˉ\bar{X} 与S2S^2 相互独立

设X1,...,XnX_1,...,X_n 是来自正态总体X∼N(μ1,σ12)X\sim N(\mu_1,\sigma_1^2) 的一组样本,设Y1,...,YnY_1,...,Y_n 是来自正态总体Y∼N(μ2,σ22)Y\sim N(\mu_2,\sigma_2^2) 的一组样本,且两组样本间独立。则:

  • SX2/σ12SY2/σ22∼F(m−1,n−1)\frac{S_X^2/\sigma_1^2}{S_Y^2/\sigma_2^2}\sim F(m-1,n-1)
  • 剩下两个分布太麻烦了

# 参数估计和假设检验

# 参数的点估计

参数估计是根据样本对总体未知参数(如均值,方差)等进行估计的一种统计推断方法。

  • 参数点估计:构造一个统计量θ^=θ^(X1,...,Xn)\hat{\theta}=\hat{\theta}(X_1,...,X_n),直接用θ^\hat{\theta} 作为θ\theta 的估计值。

# 矩估计

  • 矩估计法是用样本的 k 阶原点矩作为总体的 **k 阶原点矩E[Xk]E[X^k]** 的估计。

考虑要估计的参数是θ1,...,θm\theta_1,...,\theta_m,于是可以列出方程组:

{E[X]=f1(θ1,...,θm)=1n∑i=1nXiE[X2]=f2(θ1,...,θm)=1n∑i=1nXi2...E[Xm]=fm(θ1,...,θm)=1n∑i=1nXim\begin{cases}E[X]=f_1(\theta_1,...,\theta_m)=\frac{1}{n}\sum_{i=1}^n X_i\\ E[X^2]=f_2(\theta_1,...,\theta_m)=\frac{1}{n}\sum_{i = 1}^n X_i^2\\ ...\\ E[X^m]=f_m(\theta_1,...,\theta_m)=\frac{1}{n}\sum_{i=1}^n X_i^m \end{cases}

然后可以解方程组得到一组解(θ1^,...,θm^)(\hat{\theta_1},...,\hat{\theta_m}),就可以作为参数(θ1,...,θm)(\theta_1,...,\theta_m) 的估计。

根据大数定律,有:

∀ε>0,lim⁡n→∞P(∣1n∑i=1nXim−E[Xm]∣<ε)=1\forall\varepsilon>0,\lim_{n\rightarrow\infin}P(|\frac{1}{n}\sum_{i=1}^nX_i^m-E[X^m]|<\varepsilon)=1

所以样本的 k 阶原点矩就是总体的 k 阶原点矩的一个合理估计。

[例]:已知总体 X 的一组样本X1,X2,...,XnX_1,X_2,...,X_n,试估计总体的方差和均值。(假设它们存在)

  • 列出方程组:

    {μ=E[X]=1n∑i=1nXi=Xˉμ2+σ2=E[X2]=1n∑i=1nXi2\begin{cases}\mu=E[X]=\frac{1}{n}\sum_{i=1}^n X_i=\bar{X}\\ \mu^2+\sigma^2=E[X^2]=\frac{1}{n}\sum_{i=1}^n X_i^2 \end{cases}

    解得:

    μ^=Xˉσ2^=1n∑i=1nXi2−Xˉ2=1n∑i=1n(Xi−Xˉ)2=n−1nS2\hat{\mu}=\bar{X}\\ \hat{\sigma^2}=\frac{1}{n}\sum_{i=1}^nX_i^2-\bar{X}^2=\frac{1}{n}\sum_{i=1}^n(X_i-\bar{X})^2=\frac{n-1}{n}S^2

  • 从例题中,可以看到,估计实际上就是把总体的参数用以样本为自变量的函数来表示,当我们获得了一组样本值时,我们就可以对总体进行合理猜测,这就是统计,用获得的一部分数据去估计整体。

# 最大似然估计

考虑我们有一组样本值x1,...,xnx_1,...,x_n,于是事件A={X1=x1,...,Xn=xn}A=\{X_1=x_1,...,X_n=x_n\} 发生的概率是一个关于参数θ=(θ1,...,θm)\theta=(\theta_1,...,\theta_m) 的函数L(θ)L(\theta)。我们希望取得θ\theta 的一个最大似然估计θ^\hat{\theta},此时L(θ^)L(\hat{\theta}) 取得最大值。

  • L(θ)L(\theta) 的确定:

    • 若总体是离散型的,则显然:P(X1=x1,...,Xn=xn)=∏i=1nP(Xi=xi)P(X_1=x_1,...,X_n=x_n)=\prod_{i=1}^nP(X_i=x_i),而P(Xi=xi)P(X_i=x_i) 是关于θ\theta 的函数。
    • 若总体是连续型的,则要求L(θ)=∏i=1n∫xixi+dxif(t)dt≈∏i=1nf(xi)dxi(dxi→0)L(\theta)=\prod_{i=1}^n \int_{x_i}^{x_i+dx_i}f(t)dt\approx\prod_{i=1}^nf(x_i)dx_i(dx_i\rightarrow 0),f(x)f(x) 是概率密度函数。
  • θ^\hat{\theta} 的确定:

    • 因为我们不关心L(θ)L(\theta) 的最大值,而只关心取得最大值时θ\theta 的值。于是我们可以对L(θ)L(\theta) 取自然对数再求导(不影响极值点),这也可以证明:

      lnL(θ)=ln(∏i=1nf(xi)dxi)=∑i=1nln(f(xi))+∑i=1nln(dxi)∂lnL(θ)∂θ=∑i=1n∂ln(f(xi))∂θlnL(\theta)=ln(\prod_{i=1}^nf(x_i)dx_i)=\sum_{i=1}^nln(f(x_i))+\sum_{i=1}^nln(dx_i)\\ \frac{\partial lnL(\theta)}{\partial\theta}=\sum_{i=1}^n\frac{\partial ln(f(x_i))}{\partial\theta}

      因为dxidx_i 与θ\theta 无关,因此连续型的最大似然估计也可以直接选为L(θ)=∏i=1nf(xi)L(\theta)=\prod_{i=1}^nf(x_i)。

设X∼N(μ,σ2)X\sim N(\mu,\sigma^2),已知XX 的一组样本观测值x1,...,xnx_1,...,x_n,求μ,σ2\mu,\sigma^2 的最大似然估计。

L(μ,σ2)=∏i=1nf(xi)=∏i=1n12πσe−(xi−μ)22σ2lnL(μ,σ2)=−n2ln(2π)−n2lnσ2−12σ2∑i=1n(xi−μ)2{∂lnL(μ,σ2)∂μ=0∂lnL(μ,σ2)∂σ2=0⇒μ^=xˉ,σ2^=n−1ns2L(\mu,\sigma^2)=\prod_{i=1}^nf(x_i)=\prod_{i=1}^n\frac{1}{\sqrt{2\pi}\sigma}e^{-\frac{(x_i-\mu)^2}{2\sigma^2}}\\ lnL(\mu,\sigma^2)=-\frac{n}{2}ln(2\pi)-\frac{n}{2}ln\sigma^2-\frac{1}{2\sigma^2}\sum_{i=1}^n(x_i-\mu)^2\\ \begin{cases}\frac{\partial lnL(\mu,\sigma^2)}{\partial\mu}=0\\ \frac{\partial lnL(\mu,\sigma^2)}{\partial\sigma^2}=0 \end{cases} \Rightarrow \hat{\mu}=\bar{x},\hat{\sigma^2}=\frac{n-1}{n}s^2

  • 注意严格来说,最大似然估计是要知道样本的观测值的,当然也可以设成字母表示a1,...,ana_1,...,a_n。但用X1,...,XnX_1,...,X_n 来表示是不合理的。

# 估计量优劣的评价标准

通常用均方误差MSE(θ^)=E[(θ−θ^)2]MSE(\hat{\theta})=E[(\theta-\hat{\theta})^2] 来评价估计量的偏离程度。

  • MSE(θ^)=E[[(θ^−E[θ^])+(E[θ^]−θ)]2]=E[(θ^−E[θ^])2]+2(E[θ^]−θ)E[θ^−E[θ^]]+E[(E[θ^]−θ)2]=E[(θ^−E[θ^])2]+(E[θ^]−θ)2=D(θ^)+(E[θ^]−θ)2MSE(\hat{\theta})=E[[(\hat{\theta}-E[\hat{\theta}])+(E[\hat{\theta}]-\theta)]^2]\\ =E[(\hat{\theta}-E[\hat{\theta}])^2]+2(E[\hat{\theta}]-\theta)E[\hat{\theta}-E[\hat{\theta}]]+E[(E[\hat{\theta}]-\theta)^2]\\ =E[(\hat{\theta}-E[\hat{\theta}])^2]+(E[\hat{\theta}]-\theta)^2\\ =D(\hat{\theta})+(E[\hat{\theta}]-\theta)^2

    其中,中间项为 0 是因为E[θ^−E[θ^]]=E[θ^]−E[θ^]=0E[\hat{\theta}-E[\hat{\theta}]]=E[\hat{\theta}]-E[\hat{\theta}]=0。

    式子中将θ^\hat{\theta} 作为随机变量,而把θ\theta 作为已知常量。我的理解是,先给出一组样本X1,...,XnX_1,...,X_n,然后这些样本都是和总体同分布的随机变量,此时可以进行点估计:θ^=f(X1,...,Xn)\hat{\theta}=f(X_1,...,X_n),所以可以对θ^\hat{\theta} 取期望。然后假如已知了参数θ\theta,此时我们可以θ^\hat{\theta} 成了未知量,因为样本没有被观测。然后我们可以计算出θ^\hat{\theta} 偏离已知的θ\theta 的距离的平方的期望。

  • 当E[θ^]−θ=0E[\hat{\theta}]-\theta=0 时,即E[θ^]=θE[\hat{\theta}]=\theta 时,我们称估计量是无偏的。这是好满足的。

  • 但D(θ^)=0D(\hat{\theta})=0 是不可满足的,因为若θ^\hat{\theta} 是一个常数而与样本无关了,那显然不太合理。通常我们在无偏的估计中,选择方差最小的,也就是最有效的,称为最小无偏估计。

若E[θ^]=θE[\hat{\theta}]=\theta,则称θ^\hat{\theta} 是θ\theta 的无偏估计,若lim⁡n→∞E[θ^]=θ\lim_{n\rightarrow\infin}E[\hat{\theta}]=\theta,则称θ^\hat{\theta} 是θ\theta 的渐进无偏估计。否则就是有偏估计。

  • 这里可以解释下之前留下的问题,为什么样本方差S2S^2 中除以的是n−1n-1。我们来证明:E[S2]=σ2E[S^2]=\sigma^2,即S2S^2 是σ2\sigma^2 的无偏估计。

    E[S2]=1n−1E[∑i=1nXi2−2Xˉ∑i=1nXi+∑i=1nXˉ2]=1n−1E[∑i=1nXi2−nXˉ2]=1n−1(∑i=1nE[Xi2]−nE[Xˉ2])=nn−1(E[X2]−E[Xˉ2])E[S^2]=\frac{1}{n-1}E[\sum_{i=1}^nX_i^2-2\bar{X}\sum_{i=1}^nX_i+\sum_{i=1}^n\bar{X}^2]\\ =\frac{1}{n-1}E[\sum_{i=1}^nX_i^2-n\bar{X}^2]\\ =\frac{1}{n-1}(\sum_{i=1}^nE[X_i^2]-nE[\bar{X}^2])\\ =\frac{n}{n-1}(E[X^2]-E[\bar{X}^2])\\

    而

    E[Xˉ]=μ,D[Xˉ]=σ2n⇒E[Xˉ2]=μ2+σ2nE[X]=μ,D[X]=σ2⇒E[X2]=μ2+σ2∴E[S2]=nn−1(μ2+σ2−μ2−σ2n)=σ2E[\bar{X}]=\mu,D[\bar{X}]=\frac{\sigma^2}{n}\Rightarrow E[\bar{X}^2]=\mu^2+\frac{\sigma^2}{n}\\ E[X]=\mu,D[X]=\sigma^2\Rightarrow E[X^2]=\mu^2+\sigma^2\\ \therefore E[S^2]=\frac{n}{n-1}(\mu^2+\sigma^2-\mu^2-\frac{\sigma^2}{n})=\sigma^2

    因此S2S^2 是σ2\sigma^2 的一个无偏估计。

  • 事实上,样本均值和样本方差总是总体均值和总体方差的无偏估计。

若对任意的ε>0\varepsilon>0,有lim⁡n→∞P(∣θ−θn^∣≥ε)=0\lim_{n\rightarrow \infin}P(|\theta-\hat{\theta_n}|\geq\varepsilon)=0,则称θ^(X1,...,Xn)\hat{\theta}(X_1,...,X_n) 是θ\theta 的一个相合(一致)估计。

  • 若lim⁡n→∞E[θn^]=θ,lim⁡n→∞D(θn^)=0\lim_{n\rightarrow\infin}E[\hat{\theta_n}]=\theta,\lim_{n\rightarrow\infin}D(\hat{\theta_n})=0,则θ^n\hat{\theta}_n 是θ\theta 的一个相合估计。

# 参数的区间估计

设θ^1,θ^2\hat{\theta}_1,\hat{\theta}_2 是两个统计量,若P(θ^1≤θ≤θ^2)=1−αP(\hat{\theta}_1\leq \theta\leq\hat{\theta}_2)=1-\alpha,则称随即区间[θ^1,θ^2][\hat{\theta}_1,\hat{\theta}_2] 是θ\theta 的一个区间估计或置信区间,1−α1-\alpha 称为置信水平或置信度。

  • 一般来说,置信度越高,精确性(区间长度)越差(越长)。

求解置信区间的一般方法为:

  • 找一个与要估计的参数θ\theta 有关的统计量TT,一般是θ\theta 的一个良好的点估计θ^\hat{\theta}。
  • 设法找出TT 和θ\theta 的某一函数H(T,θ)H(T,\theta),要求 H 的分布已知且与T,θT,\theta 无关,称为枢轴变量。
  • 寻找合适的常数c,dc,d 使得P(c≤H≤d)=1−αP(c\leq H\leq d)=1-\alpha。
  • 将c≤H≤dc\leq H\leq d 等价变形为θ^1≤θ≤θ^2\hat{\theta}_1\leq\theta\leq\hat{\theta}_2。

正态分布的置信区间:

评估参数 条件 枢轴变量及其分布 置信区间
μ\mu σ2\sigma^2 已知 Xˉ−μσ/n∼N(0,1)\frac{\bar{X}-\mu}{\sigma/\sqrt{n}}\sim N(0,1) [Xˉ−uα/2σn,Xˉ+uα/2σn][\bar{X}-u_{\alpha/2}\frac{\sigma}{\sqrt{n}},\bar{X}+u_{\alpha/2}\frac{\sigma}{\sqrt{n}}]
μ\mu σ2\sigma^2 未知 Xˉ−μS/n∼t(n−1)\frac{\bar{X}-\mu}{S/\sqrt{n}}\sim t(n-1) [Xˉ−tα/2(n−1)Sn,Xˉ+tα/2(n−1)Sn][\bar{X}-t_{\alpha/2}(n-1)\frac{S}{\sqrt{n}},\bar{X}+t_{\alpha/2}(n-1)\frac{S}{\sqrt{n}}]
σ2\sigma^2 μ\mu 已知 ∑i=1nXi−μσ2∼χ2(n)\sum_{i=1}^n\frac{ X_i-\mu}{\sigma}^2\sim\chi^2(n) [∑(Xi−μ)2χα/22(n),∑(Xi−μ)2χ1−α/22(n)][\frac{\sum(X_i-\mu)^2}{\chi_{\alpha/2}^2(n)},\frac{\sum(X_i-\mu)^2}{\chi_{1-\alpha/2}^2(n)}]
σ2\sigma^2 μ\mu 未知 (n−1)S2σ2∼χ2(n−1)\frac{(n-1)S^2}{\sigma^2}\sim\chi^2(n-1) [(n−1)S2χα/22(n−1),(n−1)S2χ1−α/22(n−1)][\frac{(n-1)S^2}{\chi_{\alpha/2}^2(n-1)},\frac{(n-1)S^2}{\chi_{1-\alpha/2}^2(n-1)}]

# 假设检验

只对总体的某些未知参数作出假设,通过抽样来判断假设是否成立,这种检验称为参数检验。

只对未知分布函数的类型或者它的某些特性提出假设,然后对这种假设进行检验,被称为非参数检验。

参数检验的步骤 —— 以对期望假设为例:

  • 建立假设:

    H0:μ=5800,H1:μ≠5800H_0:\mu=5800,H_1:\mu\neq 5800

    H0H_0 称为原假设,H1H_1 称为备择假设。

  • 选取检验统计量(不能含未知参数):

    通过比较原假设成立时统计量的分布和备择假设成立时统计量的分布,得出对原假设不利的事件。若总体的方差已知,可以选择统计量:

    U=Xˉ−5800σ/nU=\frac{\bar{X}-5800}{\sigma/\sqrt{n}}

    H0H_0 成立时,U∼N(0,1)U\sim N(0,1),H1H_1 成立时,U∼N(μ−5800σ/n,1)U\sim N(\frac{\mu-5800}{\sigma/\sqrt{n}},1)。所以我们可以选择对H0H_0 不利的事件为{∣U∣>C}\{|U|>C\}。若事件发生了,我们便拒绝H0H_0。

  • 选取检验显著性水平α\alpha 与临界值,进而确定H0H_0 的拒绝区域。

    在我们总是倾向于 “保护 “原假设的。于是我们默认在原假设成立的前提下,若对H0H_0 不利的事件还是发生了,就拒绝原假设:

    P(∣U∣>C∣H0)=αP(|U|>C|H_0)=\alpha

    若α=0.05\alpha=0.05,则可以得出P(∣U∣>C∣H0)=0.05⇒C=u0.025P(|U|>C|H_0)=0.05\Rightarrow C=u_{0.025}。因为H0H_0 成立时,UU 是标准正态分布。

  • 做判断:

    根据样本的观测值,计算UU,和CC 进行比较。若∣U∣>C|U|>C 就拒绝H1H_1。

这里对P(∣U∣>C∣H0)=αP(|U|>C|H_0)=\alpha 我的理解是:若H0H_0 成立的话,发生∣U∣>C|U|>C 的概率很小很小,所以现实中发生了的话我们只好认为H0H_0 不成立了。

假设检验不一定原假设一定形如a=a0a=a_0,其本质是把参数θ\theta 分成两个不相交的空间:

H0:θ∈Θ0,H1:θ∈Θ−Θ0=Θ1H_0:\theta\in\Theta_0,H_1:\theta\in\Theta-\Theta_0=\Theta_1

若Θ1\Theta_1 在Θ0\Theta_0 的两侧(如例子)就叫做双侧检验,否则也可以有Θ1\Theta_1 在Θ0\Theta_0 的右侧或左侧的单侧检验。


假设检验可能有两种错误,弃真和存伪

  • 弃真:H0H_0 成立,但拒绝事件∣U∣>C|U|>C 发生了,所以拒绝了H0H_0。弃真的概率就是显著性水平α\alpha。
  • 存伪:H1H_1 成立,却接受了H0H_0。它的概率比较难以计算,记为β\beta。

事实上,有当样本数nn 固定时,α\alpha 增大β\beta 就会减小,α\alpha 减小β\beta 就会增大。但增大样本数nn 可以使得α\alpha 和β\beta 都减小。(抽样的值多了更准确)

给出一个样本观测值UU,能做出” 拒绝H0H_0“的最小的α\alpha 值称为检验的 p 值。

  • 一般模拟抽样的软件不仅会告诉你模拟抽取的样本观测值,同样也会告诉你该观测值下的 p 值。这样你就不需要去比较UU 和uα/2u_{\alpha/2} 了,而只用比较α\alpha 和 p。

# 正态总体参数的假设检验

条件 原假设H0H_0 备选假设H1H_1 检验统计量 拒绝域
σ2=σ02\sigma^2=\sigma_0^2 已知 μ=μ0\mu=\mu_0 μ≠μ0\mu\neq\mu_0 U=Xˉ−μ0σ0/nU=\frac{\bar{X}-\mu_0}{\sigma_0/\sqrt{n}} $ U >u_{\alpha/2}$
μ≤μ0\mu\leq\mu_0 μ>μ0\mu>\mu_0 服从正态分布 U>uαU>u_\alpha
μ≥μ0\mu \geq\mu_0 μ<μ0\mu <\mu_0 U<−uαU<-u_\alpha
σ2\sigma^2 未知 μ=μ0\mu=\mu_0 μ≠μ0\mu\neq\mu_0 T=Xˉ−μ0S/nT=\frac{\bar{X}-\mu_0}{S/\sqrt{n}} 服从 t 分布 $ T >t_{\alpha/2}(n-1)$
μ≤μ0\mu\leq\mu_0 μ>μ0\mu>\mu_0 T>tα(n−1)T>t_{\alpha}(n-1)
μ≥μ0\mu \geq\mu_0 μ<μ0\mu <\mu_0 T<−tα(n−1)T<-t_{\alpha}(n-1)
μ=μ0\mu=\mu_0 已知 σ2=σ02\sigma^2=\sigma_0^2 σ2≠σ02\sigma^2\neq\sigma_0^2 χ2=∑i=1n(Xi−μ0σ0)2\chi^2=\sum_{i=1}^n(\frac{X_i-\mu_0}{\sigma_0})^2 服从卡方分布 χ2>χα/22(n)\chi^2>\chi^2_{\alpha/2}(n) 或χ2<χ1−α/22(n)\chi^2<\chi_{1-\alpha/2}^2(n)
σ2≤σ02\sigma^2\leq\sigma_0^2 σ2>σ02\sigma^2>\sigma_0^2 χ2>χα2(n)\chi^2>\chi_{\alpha}^2(n)
σ2≥σ02\sigma^2\geq\sigma_0^2 σ2<σ02\sigma^2<\sigma_0^2 χ2<χ1−α2(n)\chi^2<\chi_{1-\alpha}^2(n)
μ\mu 未知 σ2=σ02\sigma^2=\sigma_0^2 σ2≠σ02\sigma^2\neq\sigma_0^2 χ2=(n−1)S2σ02\chi^2=\frac{(n-1)S^2}{\sigma_0^2} 服从卡方分布 χ2>χα/22(n−1)\chi^2>\chi_{\alpha/2}^2(n-1) 或χ2<χ1−α/22(n−1)\chi^2<\chi_{1-\alpha/2}^2(n-1)
σ2≤σ02\sigma^2\leq\sigma_0^2 σ2>σ02\sigma^2>\sigma_0^2 χ2>χα2(n−1)\chi^2>\chi_{\alpha}^2(n-1)
σ2≥σ02\sigma^2\geq\sigma_0^2 σ2<σ02\sigma^2<\sigma_0^2 χ2<χ1−α2(n−1)\chi^2<\chi_{1-\alpha}^2(n-1)

简单证明下对方差估计的部分,怎么考虑不等号呢?以第八行的情况为例,若H0H_0 成立,就有:

χ2=∑i=1n(Xi−μ0σ0)2=σ2σ02∑i=1n(Xi−μ0σ)2≤χ2(n)\chi^2=\sum_{i=1}^n(\frac{X_i-\mu_0}{\sigma_0})^2=\frac{\sigma^2}{\sigma_0^2}\sum_{i=1}^n(\frac{X_i-\mu_0}{\sigma})^2\leq \chi^2(n)

若H1H_1 成立,则有χ2>χ2(n)\chi^2>\chi^2(n)。(σ2\sigma^2 是真实的方差,σ02\sigma_0^2 是假设的方差)所以χ2\chi^2 的观测值越大,对H0H_0 越不利,对X1X_1 越有利。

<P(χ2>χα2(n)∣H0)≤P(χ2>χα2(n)∣σ2=σ02)=α {<} P(\chi^2>\chi_{\alpha}^2(n)|H_0)\leq P(\chi^2>\chi_{\alpha}^2(n)|\sigma^2=\sigma_0^2)=\alpha

所以选择的拒绝域是χ2>χα2(n)\chi^2>\chi_{\alpha}^2(n)。

# 一元线性回归和方差分析

# 一元线性回归

已知随机变量YY 满足以下关系:

{Y=β0+β1X+εE[ε]=0,D(ε)=σ2\begin{cases}Y=\beta_0+\beta_1 X+\varepsilon\\E[\varepsilon]=0,D(\varepsilon)=\sigma^2\end{cases}

σ2\sigma^2 未知。那么我们可以通过抽取一堆样本(x1,y1),...,(xn,yn)(x_1,y_1),...,(x_n,y_n) 去估计β0\beta_0 和β1\beta_1 的值,得到回归直线Y=β0^+β1^XY=\hat{\beta_0}+\hat{\beta_1}X。

再根据这条直线,可以给出XX 得到 Y 的估测值Y^\hat{Y}。

注意:一元线性回归中,默认自变量是非随机变量。怎么理解呢,可以理解为,给定一个x0x_0,有一个随机变量YY,而x0x_0 是随机变量YY 的一个参数,影响着YY 的分布。而这个影响实际上就是线性影响着。但参数XX 总是会被给出的,而参数β0,β1\beta_0,\beta_1 是可以用样本估计的,于是这三个参数都有值了后就可以讨论YY 的分布。而回归问题,其实就是默认参数XX 的值已知非随机的情况下,分析YY 和XX 的关系。

最小二乘法:

  • 定义偏差平方和:

    Q(β0,β1)=∑i=1n[yi−(β0+β1xi)]2Q(\beta_0,\beta_1)=\sum_{i=1}^n[y_i-(\beta_0+\beta_1x_i)]^2

    我们要找出β0\beta_0 和β1\beta_1 的合理取值β0^,β1^\hat{\beta_0},\hat{\beta_1},使得Q(β0^,β1^)Q(\hat{\beta_0},\hat{\beta_1}) 尽量小。于是有:

    {∂Q(β0,β1)∂β0=0∂Q(β0,β1)∂β1=0⇒{β0^+xˉβ1^=yˉnxˉβ0^+β1^∑i=1nxi2=∑i=1nxiyi\begin{cases}\frac{\partial Q(\beta_0,\beta_1)}{\partial\beta_0}=0\\\frac{\partial Q(\beta_0,\beta_1)}{\partial\beta_1}=0\end{cases} \Rightarrow\begin{cases}\hat{\beta_0}+\bar{x}\hat{\beta_1}=\bar{y}\\n\bar{x}\hat{\beta_0}+\hat{\beta_1}\sum_{i=1}^nx_i^2=\sum_{i=1}^nx_iy_i\end{cases}

    解得:

    β1^=LxyLxx,β0^=yˉ−xˉβ1^Lxy=∑i=1n(xi−xˉ)(yi−yˉ)=∑i=1nxiyi−nxˉyˉLxx=∑i=1n(xi−xˉ)2=∑i=1nxi2−nxˉ2\hat{\beta_1}=\frac{L_{xy}}{L_{xx}},\hat{\beta_0}=\bar{y}-\bar{x}\hat{\beta_1}\\ L_{xy}=\sum_{i=1}^n(x_i-\bar{x})(y_i-\bar{y})=\sum_{i=1}^nx_iy_i-n\bar{x}\bar{y}\\ L_{xx}=\sum_{i=1}^n(x_i-\bar{x})^2=\sum_{i=1}^nx_i^2-n\bar{x}^2\\

    这样估计的参数β0,β1\beta_0,\beta_1 的值的方法称为最小二乘法(OLS),得到了一元线性回归方程,显然它一定过(xˉ,yˉ)(\bar{x},\bar{y})。

  • 最小二乘法估计是无偏的:

    E[β0^]=β0,E[β1^]=β1E[\hat{\beta_0}]=\beta_0,E[\hat{\beta_1}]=\beta_1

    * 注意:在一元线性回归中,默认自变量是非随机变量,于是有:

    β1^=∑i=1n(xi−xˉ)(yi−yˉ)Lxx=∑i=1nxi−xˉLxxyiE[β1^]=∑i=1nxi−xˉLxxE[yi]∵E[yi]=β0+β1xi+E[ε]=β0+β1xi∴E[β1^]=∑i=1nxi−xˉLxx(β0+β1xi)=∑i=1nxi−xˉLxxβ1xi=β1∑i=1n(xi−xˉ)2Lxx=β1\hat{\beta_1}=\frac{\sum_{i=1}^n(x_i-\bar{x})(y_i-\bar{y})}{L_{xx}}=\sum_{i=1}^n\frac{x_i-\bar{x}}{L_{xx}}y_i\\ E[\hat{\beta_1}]=\sum_{i=1}^n\frac{x_i-\bar{x}}{L_{xx}}E[y_i]\\ \because E[y_i]=\beta_0+\beta_1x_i+E[\varepsilon]=\beta_0+\beta_1x_i\\ \therefore E[\hat{\beta_1}]=\sum_{i=1}^n\frac{x_i-\bar{x}}{L_{xx}}(\beta_0+\beta_1x_i)=\sum_{i=1}^n\frac{x_i-\bar{x}}{L_{xx}}\beta_1 x_i\\ =\beta_1\sum_{i=1}^n\frac{(x_i-\bar{x})^2}{L_{xx}}=\beta_1

    注意到Y=β0+β1X+εY=\beta_0+\beta_1X+\varepsilon 中随机变量实际上只有YY 和ε\varepsilon。而xi,β0,β1x_i,\beta_0,\beta_1 都是固定参数。此外上述推导过程反复用到了C∗∑i=1nxi−xˉLxx=0C*\sum_{i=1}^n\frac{x_i-\bar{x}}{L_{xx}}=0。

  • 最小二乘法估计是有效的:

    在所有β0^,β1^\hat{\beta_0},\hat{\beta_1} 关于y1,..,yny_1,..,y_n 是线性的函数估计中,最小二乘法是方差最小的。再强调一遍xix_i 只是给定的固定参数。

  • 最小二乘法估计的可靠性:

    最小二乘法做出的估计值可以使得残差平方和最小:

    Q(β0^,β1^)=∑i=1n[yi−β0^−β1^xi]2Q(\hat{\beta_0},\hat{\beta_1})=\sum_{i=1}^n[y_i-\hat{\beta_0}-\hat{\beta_1}x_i]^2

    用正交变换可以证明:

    Q(β0^,β1^)σ2∼χ2(n−2)\frac{Q(\hat{\beta_0},\hat{\beta_1})}{\sigma^2}\sim\chi^2(n-2)

    因此E[Q(β0^,β1^)σ2]=n−2,E[Q(β0^,β1^)n−2]=σ2E[\frac{Q(\hat{\beta_0},\hat{\beta_1})}{\sigma^2}]=n-2,E[\frac{Q(\hat{\beta_0},\hat{\beta_1})}{n-2}]=\sigma^2。即σ2^=Q(β0^,β1^)n−2\hat{\sigma^2}=\frac{Q(\hat{\beta_0},\hat{\beta_1})}{n-2} 是一个σ2\sigma^2 的一个无偏估计,称为剩余方差。

    这里是对 Y 的方差进行估计,而D(Y)=D(β0)+D(β1X)+D(ε)=D(ε)=σ2D(Y)=D(\beta_0)+D(\beta_1X)+D(\varepsilon)=D(\varepsilon)=\sigma^2。强调 X 也是非随机变量。

# 回归方程的显著性检验

多数情况下是不知道YY 与XX 是否是线性相关的,于是需要进行假设检验。∣β1∣|\beta_1| 越大,说明线性性越强。做假设:

H0:β1=0,H1:β1≠0H_0:\beta_1=0,H_1:\beta_1\neq 0

可以证明有以下等式:

Lyy=Q+ULyy=∑i=1n(yi−yˉ)2Q=∑i=1n(yi−β0^−β1^xi)2U=∑i=1n(β0^+β1^xi−yˉ)2=β1^2LxxL_{yy}=Q+U\\ L_{yy}=\sum_{i=1}^n(y_i-\bar{y})^2\\ Q=\sum_{i=1}^n(y_i-\hat{\beta_0}-\hat{\beta_1}x_i)^2\\ U=\sum_{i=1}^n(\hat{\beta_0}+\hat{\beta_1}x_i-\bar{y})^2=\hat{\beta_1}^2L_{xx}

其中,即为离差平方和Lyy=L_{yy}= 残差平方和Q+Q+ 回归平方和UU。它表明:

Y 的 n 个观测值的离散程度LyyL_{yy} 可分解为两部分:Q 表示样本值没有落在回归直线上引起的,U 表示由回归系数β^\hat{\beta} 本身引起的。因此,若QQ 越大,就表示线性性越差,反之,若Q=0Q=0,则样本都落在回归直线上,说明线性性很强。

不难证明,F=UQ/(n−2)∼F(1,n−2)F=\frac{U}{Q/(n-2)}\sim F(1,n-2)。结论是,若F>Fα(1,n−2)F>F_\alpha(1,n-2),则拒绝H0H_0,认为存在线性性。


预测:给定一个x0x_0,Y0Y_0 的点预测值为Yi^=β0^+β1^x0\hat{Y_i}=\hat{\beta_0}+\hat{\beta_1}x_0,同样也可以对它进行置信区间预测。Y0Y_0 的置信水平为1−α1-\alpha 的置信区间为:

[Y0^−δ(x0),Y0^+δ(x0)]δ(x0)=σ2^tα/2(n−2)1+1n+(x0−xˉ)2Lxx[\hat{Y_0}-\delta(x_0),\hat{Y_0}+\delta(x_0)]\\ \delta(x_0)=\sqrt{\hat{\sigma^2}}t_{\alpha/2}(n-2)\sqrt{1+\frac{1}{n}+\frac{(x_0-\bar{x})^2}{L_{xx}}}

# 单因素方差分析

设因素 A 有 r 个水平A1,A2,...,ArA_1,A_2,...,A_r,水平AiA_i 条件下试验结果的全体记为总体XiX_i,假定Xi∼N(μi,σ2)X_i\sim N(\mu_i,\sigma^2)。在水平AiA_i 的条件下进行nin_i 次独立试验,即:

{Xij∼N(μi,σ2)Xij相互独立,i=1,...,r,j=1,...,niμi,σ2未知\begin{cases}X_{ij}\sim N(\mu_i,\sigma^2)\\ X_{ij}相互独立,i=1,...,r,j=1,...,n_i\\ \mu_i,\sigma^2未知 \end{cases}

而单因素方差分析,就是分析不同水平下的方差有无明显差异。作假设:

H0:μ1=μ2=...=μr,H1=¬(μ1=μ2=...=μr)H_0:\mu_1=\mu_2=...=\mu_r,H_1=\neg(\mu_1=\mu_2=...=\mu_r)

记εij=Xij−μi\varepsilon_{ij}=X_{ij}-\mu_i 表示一些不可估计的随机因素对试验的影响,被称为随机误差,εij∼N(0,σ2)\varepsilon_{ij}\sim N(0,\sigma^2)。于是模型等价于:

{Xij=μi+εijεij∼N(0,σ2)且相互独立μi,σ2未知\begin{cases}X_{ij}=\mu_i+\varepsilon_{ij}\\ \varepsilon_{ij}\sim N(0,\sigma^2)且相互独立\\ \mu_i,\sigma^2未知 \end{cases}

为了方便讨论,引入一些量:

  • n=∑i=1rnin=\sum_{i=1}^rn_i 为样本总数。
  • μ=1n∑i=1rμi\mu=\frac{1}{n}\sum_{i=1}^r\mu_i 为理论总均值。
  • αi=μi−μ\alpha_i=\mu_i-\mu 为水平AiA_i 的效应。

易得,H0⇔α1=α2=...=αr=0H_0\Leftrightarrow \alpha_1=\alpha_2=...=\alpha_r=0。于是继续变换模型:

{Xij=μ+αi+εij∑i=1rniαi=0εij∼N(0,σ2)μ,αi,σ2未知\begin{cases}X_{ij}=\mu+\alpha_i+\varepsilon_{ij}\\ \sum_{i=1}^rn_i\alpha_i=0\\ \varepsilon_{ij}\sim N(0,\sigma^2)\\ \mu,\alpha_i,\sigma^2未知 \end{cases}

于是可以进行假设检验。设样本总均值Xˉ=1n∑i=1r∑j=1niXij\bar{X}=\frac{1}{n}\sum_{i=1}^r\sum_{j=1}^{n_i}X_{ij},Xiˉ=1ni∑j=1niXij\bar{X_i}=\frac{1}{n_i}\sum_{j=1}^{n_i}X_{ij} 引入总偏差平方和:

ST=∑i=1r∑j=1ni(Xij−Xˉ)2=∑i=1r∑j=1ni[(Xij−Xiˉ)+(Xiˉ−Xˉ)]2=∑i=1r∑j=1ni(Xij−Xiˉ)2+∑i=1r∑j=1ni(Xiˉ−Xˉ)2=Se+SAS_T=\sum_{i=1}^r\sum_{j=1}^{n_i}(X_{ij}-\bar{X})^2\\ =\sum_{i=1}^r\sum_{j=1}^{n_i}[(X_{ij}-\bar{X_i})+(\bar{X_i}-\bar{X})]^2\\ =\sum_{i=1}^r\sum_{j=1}^{n_i}(X_{ij}-\bar{X_i})^2+\sum_{i=1}^r\sum_{j=1}^{n_i}(\bar{X_i}-\bar{X})^2\\ =S_e+S_A

其中,交叉项2∑i=1r∑j=1ni(Xij−Xiˉ)(Xiˉ−Xˉ)=2∑i=1r(Xiˉ−Xˉ)∑j=1ni(Xij−Xiˉ)=02\sum_{i=1}^r\sum_{j=1}^{n_i}(X_{ij}-\bar{X_i})(\bar{X_i}-\bar{X})=2\sum_{i=1}^r(\bar{X_i}-\bar{X})\sum_{j=1}^{n_i}(X_{ij}-\bar{X_i})=0。

而Se=∑i=1r∑j=1ni(Xij−Xiˉ)2=∑i=1r(ni−1)Si2S_e=\sum_{i=1}^r\sum_{j=1}^{n_i}(X_{ij}-\bar{X_i})^2=\sum_{i=1}^r(n_i-1)S_i^2 反映了第ii 组样本下内部的差异,而SA=∑i=1r∑j=1ni(Xiˉ−Xˉ)2=∑i=1rni(Xiˉ−Xˉ)2S_A=\sum_{i=1}^r\sum_{j=1}^{n_i}(\bar{X_i}-\bar{X})^2=\sum_{i=1}^rn_i(\bar{X_i}-\bar{X})^2 反映了组与组之间的差异。

于是SeS_e 被称为误差平方和或组内平方和,SAS_A 被称为因素平方和或组间平方和,根据定理:

SEσ2∼χ2(n−r)SAσ2∼χ2(r−1)\frac{S_E}{\sigma^2}\sim \chi^2(n-r)\\ \frac{S_A}{\sigma^2}\sim \chi^2(r - 1)

故有

E[Se]=(n−r)σ2E[SA]=(r−1)σ2+∑i=1rniαi2E[S_e]=(n-r)\sigma^2\\ E[S_A]=(r-1)\sigma^2+\sum_{i=1}^rn_i\alpha_i^2

若H0H_0 成立,则有E[Sen−r]=E[SAr−1]=σ2E[\frac{S_e}{n-r}]=E[\frac{S_A}{r-1}]=\sigma^2,即可以把Sen−r,SAr−1\frac{S_e}{n-r},\frac{S_A}{r-1} 都当作σ2\sigma^2 的一个无偏估计。考虑这样一个统计量:

F=SA/(r−1)Se/(n−r)∼F(r−1,n−r)F=\frac{S_A/(r-1)}{S_e/(n-r)}\sim F(r-1,n-r)

显然H0H_0 成立时,FF 应趋近于 1,而H0H_0 不成立时,FF 会大于 1。于是若F>Fα(r−1,n−r)F>F_{\alpha}(r-1,n-r) 就拒绝H0H_0。

編集日 閲覧数 回